
8.2 Moderne Speicherarchitekturen - Software-defined und verteilt
Klassisches RAID bleibt eine wichtige Grundlage, schützt aber zunächst einen lokalen Verbund von Datenträgern. Virtualisierte Rechenzentren, Cloud-Plattformen und hochverfügbare Anwendungen verteilen Speicherfunktionen zusätzlich über Software, Server und Standorte. Dieses Kapitel ordnet die dabei verwendeten Begriffe und Architekturen ein.
RAID bleibt die Grundlage - aber nicht die ganze Lösung
RAID fasst mehrere Datenträger zu einem logischen Verbund zusammen und kann je nach Level Leistung, Kapazitätsnutzung oder Ausfallsicherheit verbessern. Damit ist RAID weder überholt noch automatisch eine vollständige Hochverfügbarkeitslösung. Ein lokaler RAID-Verbund schützt beispielsweise nicht gegen den Ausfall des gesamten Servers, eine fehlerhafte Anwendung, versehentliches Löschen, Schadsoftware oder den Verlust eines Standorts.
Moderne Speicherplattformen übernehmen bekannte Grundideen wie Striping, Spiegelung und Parität, wenden sie aber auf größere Fehlerdomänen an. Daten oder Redundanzinformationen können nicht nur auf verschiedenen Laufwerken, sondern auf unterschiedlichen Servern, Racks oder Standorten liegen. Die konkrete Schutzwirkung hängt von der Platzierungsregel und der tatsächlich getrennten Fehlerdomäne ab.
- RAID schützt innerhalb der dafür vorgesehenen Fehlerdomäne vor bestimmten Hardwareausfällen.
- Hochverfügbarkeit hält einen Dienst trotz definierter Ausfälle erreichbar.
- Replikation erzeugt zusätzliche Datenkopien, kann aber auch logische Fehler weiterreichen.
- Ein Backup bewahrt getrennte, wiederherstellbare Datenstände auf und muss regelmäßig getestet werden.
Die Ebenen einer modernen Speicherumgebung
Bei der Fehlersuche muss klar sein, auf welcher Ebene eine Funktion bereitgestellt wird. Eine virtuelle Maschine sieht meist nur ein virtuelles Blockgerät. Ob darunter einzelne SSDs, ein RAID-Controller, ein verteilter Cluster oder ein Cloud-Dienst arbeitet, ist im Gastbetriebssystem häufig nicht direkt erkennbar.
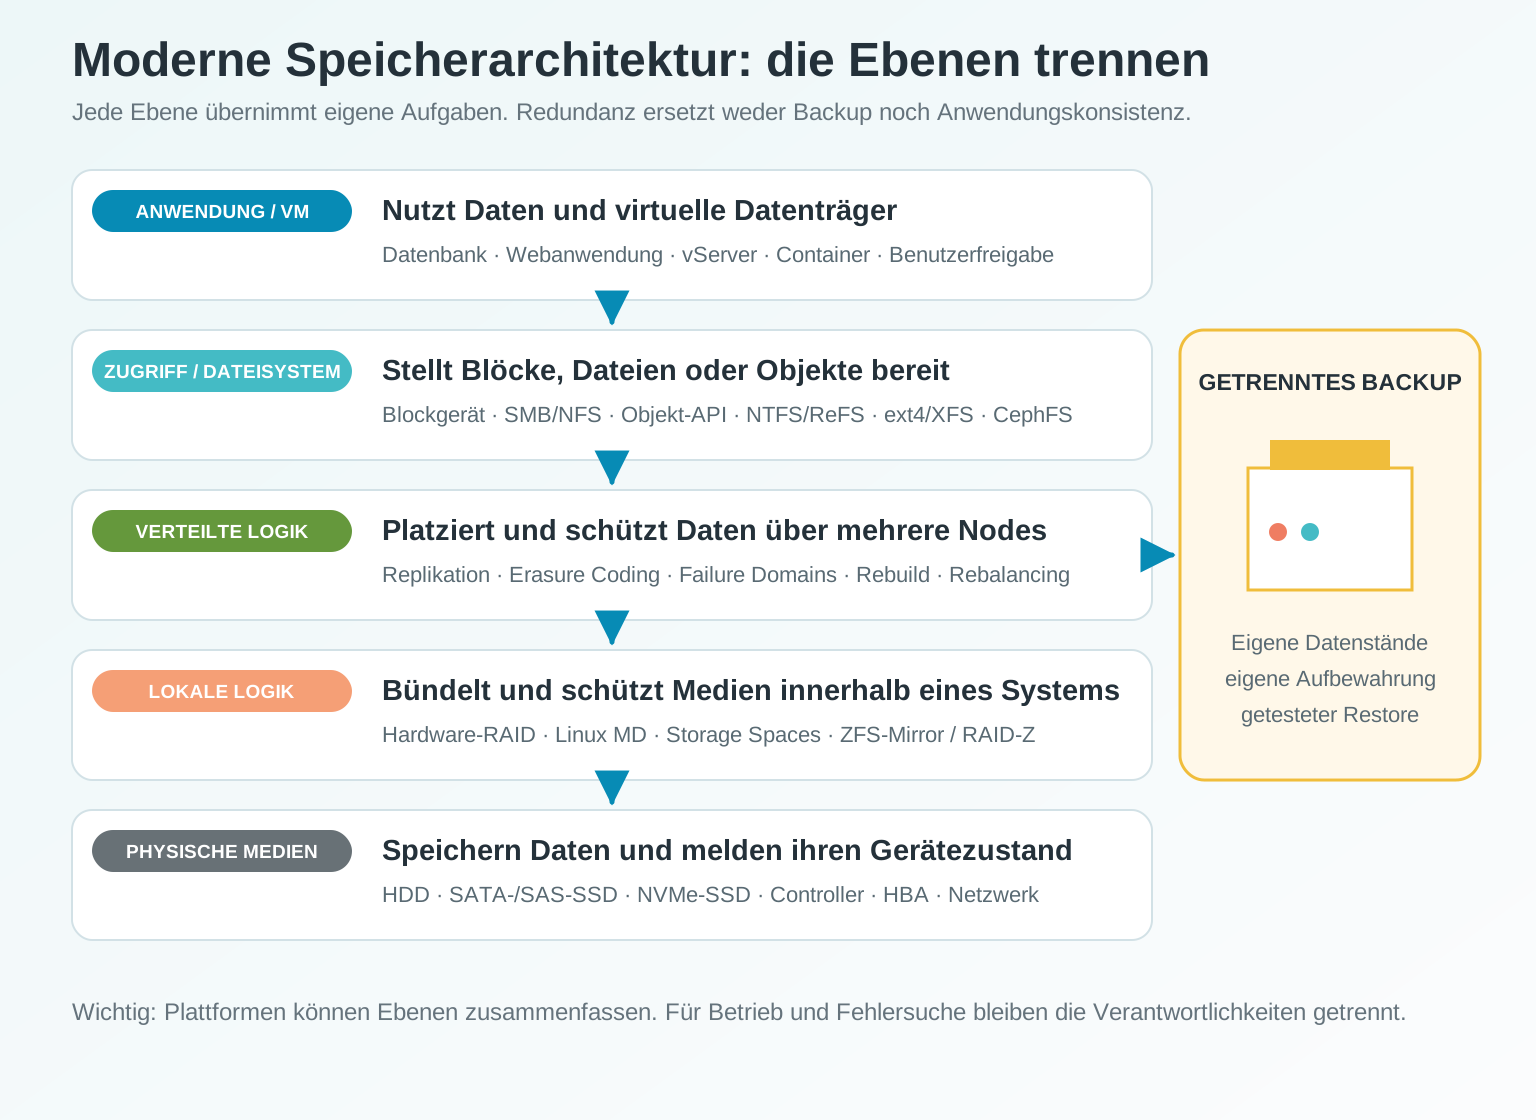
| Ebene | Typische Aufgabe | Beispiele |
|---|---|---|
| Physische Medien | Daten dauerhaft speichern und Medienfehler melden | HDD, SATA-/SAS-SSD, NVMe-SSD |
| Lokale Speicherlogik | Mehrere Medien bündeln oder lokal absichern | Hardware-RAID, Linux MD, Storage Spaces, ZFS-Mirror oder RAID-Z |
| Verteilte Speicherschicht | Daten über mehrere Knoten platzieren, replizieren und wiederherstellen | Ceph, Storage Spaces Direct |
| Zugriffsart | Speicher für Clients als Blöcke, Dateien oder Objekte bereitstellen | Blockgerät, SMB/NFS, S3-kompatible Objekt-API |
| Dateisystem und Volume | Dateien, Verzeichnisse, Metadaten und freien Speicher organisieren | NTFS, ReFS, ext4, XFS, CephFS |
| Virtualisierung und Anwendung | Virtuelle Datenträger beziehungsweise Anwendungsdaten nutzen | VHDX/QCOW2, Datenbankdateien, Container-Volumes |
| Datensicherung | Getrennte Wiederherstellungspunkte aufbewahren | Backup-Repository, Offline-/Immutable-Kopie, Standortkopie |
Software-defined Storage und Scale-out
Software-defined Storage trennt Speicherfunktionen stärker von einem einzelnen proprietären Controller. Software bildet Pools, platziert Daten, überwacht Komponenten und stellt logische Speicherressourcen bereit. Die Hardware bleibt wichtig, die Steuerung und Redundanzlogik liegt jedoch überwiegend in der Speichersoftware.
Scale-up erweitert ein vorhandenes System um mehr oder größere Laufwerke. Scale-out ergänzt weitere Speicherknoten und verteilt Kapazität sowie Last über diese Knoten. Scale-out kann den Ausfall ganzer Server berücksichtigen, benötigt dafür aber ein geeignetes Netzwerk, eine konsistente Clustersteuerung und bewusst definierte Fehlerdomänen.
| Merkmal | Scale-up | Scale-out |
|---|---|---|
| Erweiterung | Mehr Ressourcen in einem vorhandenen System | Zusätzliche Server beziehungsweise Storage-Nodes |
| Grenze | Gehäuse, Controller, Steckplätze und maximale Laufwerkszahl | Clustergröße, Netzwerk, Metadaten- und Verwaltungsarchitektur |
| Ausfallbetrachtung | Häufig Laufwerk, Controller oder einzelnes System | Zusätzlich Knoten, Rack, Netzwerkpfad und gegebenenfalls Standort |
| Datenbewegung | Oft Rebuild innerhalb des Systems | Rebuild oder Rebalancing zwischen Knoten |
Block-, Datei- und Objektspeicher unterscheiden
Die drei Zugriffsarten lösen unterschiedliche Aufgaben. Keine davon ist grundsätzlich moderner oder besser. Entscheidend sind Anwendung, Protokoll, Konsistenzanforderung, benötigte Metadaten und das Betriebsmodell.
| Speicherart | Was der Client erhält | Typische Verwendung | Wichtige Folge |
|---|---|---|---|
| Block Storage | Adressierbare Blöcke wie bei einem lokalen Datenträger | VM-Laufwerke, Datenbanken, Cluster-Volumes | Der Client oder Hypervisor verwaltet Partition und Dateisystem. Gemeinsamer Zugriff benötigt dafür geeignete Clustermechanismen. |
| File Storage | Dateien und Verzeichnisse in einem gemeinsamen Namensraum | Benutzerverzeichnisse, Abteilungsfreigaben, gemeinsam genutzte Projektdaten | Server oder Cluster verwaltet das Dateisystem; Clients greifen beispielsweise über SMB oder NFS zu. |
| Object Storage | Objekte mit Kennung, Nutzdaten und Metadaten über eine API | Backups, Medien, Archive, Data Lakes und cloudnative Anwendungen | Kein normales Blockgerät und üblicherweise keine klassischen Dateioperationen; Anwendungen nutzen die Objekt-API. |
Cluster-Dateisystem ist nicht gleich verteiltes Dateisystem
Ein Cluster-Dateisystem wie GFS2 ermöglicht mehreren Clusterknoten den koordinierten Zugriff auf dasselbe gemeinsam erreichbare Blockgerät. Verteilte Sperren, Cluster-Mitgliedschaft und Fencing verhindern, dass getrennte Knoten gleichzeitig widersprüchliche Änderungen durchführen. Die gemeinsame Blockspeicherschicht muss dabei bereits vorhanden und passend abgesichert sein.
Ein verteiltes Dateisystem verteilt Daten und Metadaten selbst über mehrere Server und stellt daraus einen gemeinsamen Namensraum bereit. CephFS verwendet beispielsweise einen Ceph Storage Cluster für die Datenablage. Der Oberbegriff verteiltes Storage ist noch weiter gefasst: Ceph kann denselben Cluster als Objekt-, Block- oder Dateispeicher bereitstellen.
| Begriff | Gemeinsame Grundlage | Zentrale Besonderheit |
|---|---|---|
| Cluster-Dateisystem | Von allen Knoten erreichbarer Blockspeicher | Koordinierter gleichzeitiger Dateisystemzugriff, Locking und Fencing |
| Verteiltes Dateisystem | Speicher- und Metadatendienste auf mehreren Knoten | Verteilter Namensraum und interne Datenplatzierung |
| Verteiltes Block Storage | Cluster stellt virtuelle Blockgeräte bereit | Geeignet für VM-Disks oder Dateisysteme auf dem Client |
| Verteiltes Object Storage | Cluster stellt Objekte über eine API bereit | Skalierbare Objektablage ohne klassisches Blockgerät |
Replikation, Erasure Coding und Self-Healing
Bei Replikation werden vollständige Kopien eines Datenobjekts oder Blocks auf getrennten Speicherzielen abgelegt. Das vereinfacht Lesezugriffe und Wiederherstellung, benötigt aber entsprechend zusätzliche Kapazität. Erasure Coding zerlegt Daten in Daten- und Redundanzfragmente. Aus einer ausreichenden Zahl verbliebener Fragmente lassen sich fehlende Teile rekonstruieren. Das ähnelt dem Grundgedanken eines Paritäts-RAIDs, arbeitet in verteilten Systemen jedoch über definierte Clusterkomponenten und Fehlerdomänen.
Self-Healing bedeutet, dass ein System erkannte fehlende oder beschädigte Kopien automatisch wieder in den gewünschten Sollzustand bringt. Dafür müssen genügend fehlerfreie Quellen, freie Kapazität und Netzwerkbandbreite vorhanden sein. Der Vorgang bleibt überwachungsbedürftig und ist kein Ersatz für eine unabhängige Sicherung.
| Verfahren | Vorteil | Abwägung |
|---|---|---|
| Replikation | Einfache Wiederherstellung und mehrere vollständige Kopien | Hoher Kapazitätsbedarf entsprechend der Kopienzahl |
| Erasure Coding | Bessere Kapazitätseffizienz bei definierter Ausfalltoleranz | Zusätzlicher Rechen-, Netzwerk- und Rekonstruktionsaufwand |
| Rebalancing | Verteilt Daten nach Erweiterung oder geänderter Auslastung neu | Erzeugt vorübergehend zusätzliche I/O- und Netzwerklast |
| Scrubbing | Prüft gespeicherte Daten und Redundanzinformationen regelmäßig | Benötigt Zeit und Ressourcen; gefundene Fehler müssen gemeldet und bewertet werden |
Clusterbegriffe, die im Betrieb entscheidend sind
- Drei Datenkopien auf demselben Server schützen nicht vor dem Ausfall dieses Servers.
- Zwei Replikate in demselben Rack schützen möglicherweise nicht vor Strom- oder Netzwerkausfall des Racks.
- Ein Cluster benötigt für Management-, Client- und Replikationsverkehr ausreichend Bandbreite und möglichst redundante Netzwerkpfade.
- Zeitquelle, Namensauflösung, Zertifikate und Monitoring gehören ebenfalls zum zuverlässigen Clusterbetrieb.
| Begriff | Bedeutung für den Speicherbetrieb |
|---|---|
| Node | Ein Server oder eine Instanz, die am Cluster teilnimmt. |
| Quorum | Entscheidungsmehrheit beziehungsweise festgelegte Abstimmungsregel, mit der ein Cluster handlungsfähige und getrennte Teilgruppen unterscheidet. |
| Split Brain | Getrennte Clusterteile halten sich gleichzeitig für zuständig. Ohne Schutz drohen widersprüchliche Schreibvorgänge und Datenverlust. |
| Fencing | Ein fehlerhafter oder isolierter Knoten wird zuverlässig vom Zugriff auf gemeinsame Ressourcen ausgeschlossen. |
| Failure Domain | Komponente, deren Ausfall gemeinsam betrachtet wird, beispielsweise Laufwerk, Server, Gehäuse, Rack oder Standort. |
| Rebuild | Fehlende Redundanz wird nach einem Ausfall wiederhergestellt. |
| Rebalancing | Daten werden neu verteilt, damit Kapazität und Last wieder zur Platzierungsregel passen. |
Praxisbeispiele richtig einordnen
| Technik | Einordnung | Typische Bereitstellung |
|---|---|---|
| Ceph | Verteilte Speicherplattform mit Objekt-, Block- und Dateizugriff; Daten werden durch OSDs gespeichert und repliziert oder per Erasure Coding geschützt. | Virtualisierungscluster, Private Cloud, Object Storage und CephFS |
| Storage Spaces Direct | Software-defined Storage von Microsoft, das lokale Laufwerke mehrerer Windows-Server zu einem Clusterpool verbindet. | Hyper-V-/Windows-Server-Cluster und Azure Local |
| GFS2 | Cluster-Dateisystem für gleichzeitigen Zugriff mehrerer Linux-Clusterknoten auf gemeinsam erreichbaren Blockspeicher. | Hochverfügbarkeitscluster mit Shared Storage und Fencing |
| Cloud Block Storage | Vom Anbieter bereitgestelltes virtuelles Blockgerät; physischer Aufbau und Redundanz liegen außerhalb der VM. | System- und Datenlaufwerke von virtuellen Maschinen |
| Cloud File Storage | Verwalteter Dateidienst, den mehrere Systeme über ein Dateifreigabeprotokoll verwenden können. | Gemeinsame Anwendungs- und Benutzerdaten |
| Cloud Object Storage | API-basierter Objektdienst mit anbieterspezifischen Klassen, Redundanz- und Lebenszyklusoptionen. | Backups, statische Inhalte, Protokolldaten und große unstrukturierte Datenmengen |
Was eine VM oder Anwendung tatsächlich sieht
Ein vServer erhält vom Anbieter normalerweise eine abstrahierte Ressource. Das Betriebssystem kann den Zustand seines virtuellen Datenträgers und Dateisystems überwachen, aber nicht automatisch die darunterliegenden Laufwerke, Storage-Nodes oder Replikate. Verantwortlichkeiten müssen deshalb aus Leistungsbeschreibung, Service Level Agreement, Plattformdokumentation und eigenem Sicherungskonzept abgeleitet werden.
Auch Anwendungen beeinflussen die Wiederherstellbarkeit. Ein Storage-Snapshot hält einen Zeitpunkt auf Speicherebene fest, ist aber ohne Koordination nicht zwingend anwendungskonsistent. Datenbanken und andere zustandsbehaftete Dienste benötigen passende Flush-, Freeze-, Quiesce- oder Backup-Verfahren. Für Entwickler bedeutet dies außerdem, Fehlerbehandlung, Wiederholungen und die Semantik des verwendeten Speicherdienstes zu berücksichtigen.
- I/O-Leistung nicht nur anhand von MB/s beurteilen: IOPS, Latenz, Blockgröße, Queue-Tiefe und Zugriffsmuster gehören dazu.
- Verfügbarkeit des Speicherdienstes und Verfügbarkeit der Anwendung getrennt betrachten.
- Snapshots, Replikation, Versionierung und Backup erfüllen unterschiedliche Aufgaben.
- Restore-Zeit, Restore-Punkt und regelmäßige Wiederherstellungstests verbindlich festlegen.
Eine Architektur systematisch auswählen
| Frage | Warum sie wichtig ist |
|---|---|
| Welche Daten und Anwendungen werden gespeichert? | Datenbank, VM, Dateifreigabe, Archiv und Object Storage erzeugen unterschiedliche Zugriffsprofile. |
| Welche Ausfälle müssen toleriert werden? | Laufwerk, Controller, Server, Rack, Netzwerk und Standort sind unterschiedliche Fehlerdomänen. |
| Wie viel Datenverlust und Ausfallzeit sind zulässig? | RPO und RTO bestimmen Replikations-, Backup- und Wiederherstellungsverfahren. |
| Wie wächst das System? | Kapazität, Leistung, Knotenanzahl und Netzwerk müssen gemeinsam skalieren. |
| Wer trägt welche Verantwortung? | Bei Cloud- und Managed-Diensten bleiben Betriebssystem, Anwendung, Berechtigungen und Backup häufig zumindest teilweise beim Kunden. |
| Wie wird der Zustand überwacht? | Kapazität, Latenz, Redundanz, Rebuild, Medienfehler und Clusterzustand benötigen Alarmierung. |
| Wie wird die Wiederherstellung geprüft? | Nur ein erfolgreich getesteter Restore belegt, dass Sicherung und Dokumentation funktionieren. |
Zusammenfassung
RAID bleibt ein Baustein moderner Speichertechnik. Software-defined und verteilte Systeme erweitern die Schutz- und Skalierungsmechanismen auf mehrere Komponenten und Knoten. Entscheidend ist nicht der Produktname, sondern das Verständnis der Ebenen, Fehlerdomänen, Zugriffsarten und Verantwortlichkeiten.
Für die Praxis gilt: Zuerst klären, wo Daten liegen und welche Schicht Redundanz bereitstellt. Danach Verfügbarkeit, Datenintegrität, Backup und Wiederherstellung getrennt planen und gemeinsam testen.
Quellen zur fachlichen Prüfung
- Ceph-Dokumentation: Architektur des Ceph Storage Clusters
- Ceph-Dokumentation: Erasure Coding
- Microsoft Learn: Storage Spaces Direct - Architektur und Einsatz
- Microsoft Learn: Fehlertoleranz und Speichereffizienz in Storage Spaces Direct
- Red Hat: GFS2-Dateisysteme konfigurieren
- OpenZFS-Dokumentation: Checksums, Redundanz und RAID-Z
PDF-Download nach Anmeldung
Zum Schutz der Unterrichtsunterlagen steht der PDF-Download ausschließlich angemeldeten Nutzern zur Verfügung.