
8.1 RAID - Grundlagen, Level und Betrieb
RAID fasst mehrere physische Datenträger zu einem oder mehreren logischen Laufwerken zusammen. Je nach RAID-Level stehen höhere Leistung, bessere Verfügbarkeit oder ein günstigeres Verhältnis aus Nutzkapazität und Redundanz im Vordergrund. RAID schützt den laufenden Betrieb vor bestimmten Datenträgerausfällen, ersetzt aber niemals ein unabhängiges Backup: Löschen, Schadsoftware, Dateisystemfehler, Fehlkonfiguration, Controllerdefekte und Standortschäden können weiterhin alle Kopien im Verbund betreffen.
Was RAID leistet - und was nicht
RAID bedeutet Redundant Array of Independent Disks. Mehrere HDDs oder SSDs werden durch Striping, Spiegelung, Parität oder eine Kombination dieser Verfahren organisiert. Das Betriebssystem sieht abhängig von der Umsetzung meist ein logisches Blockgerät. Redundanz erhöht die Verfügbarkeit während eines Datenträgerausfalls; sie garantiert weder Datenintegrität noch Wiederherstellbarkeit.
Ein Backup besitzt einen eigenen Lebenszyklus, mehrere Versionen und idealerweise eine vom Produktivsystem getrennte Kopie. Ein RAID repliziert dagegen Änderungen sofort: Wird eine Datei gelöscht oder verschlüsselt, betrifft das den Verbund. Auch ein Hot Spare ist kein Backup, sondern lediglich ein bereitstehender Ersatzdatenträger für den automatischen Rebuild.
- RAID 0 besitzt keine Redundanz und erhöht das Ausfallrisiko des gesamten Verbunds.
- RAID 1, 5, 6 und 10 können definierte Datenträgerausfälle überstehen, solange der Verbund nicht über seine Toleranz hinaus ausfällt.
- Regelmäßige, getestete Backups bleiben unabhängig vom gewählten RAID-Level erforderlich.
- Monitoring, Konsistenzprüfungen, Ersatzteilstrategie und dokumentierte Wiederherstellung gehören zum RAID-Betrieb.
Software-, Hardware- und Firmware-RAID
Historische Aussagen, Software-RAID belaste die CPU grundsätzlich stark und Hardware-RAID sei immer schneller, gelten nicht pauschal. Entscheidend sind Workload, Datenträger, Queue-Tiefe, Controller, Cache-Schutz, Treiber und Implementierung. Moderne Software-Stacks können Hardware-RAID bei Transparenz, Flexibilität und Leistung übertreffen; dedizierte Controller bleiben in anderen Umgebungen sinnvoll.
| Umsetzung | Arbeitsweise | Stärken | Grenzen und Einordnung |
|---|---|---|---|
| Software-RAID | Betriebssystem beziehungsweise Storage-Stack verwaltet Metadaten, Datenverteilung und Wiederherstellung. | Flexibel, transparent, keine spezielle Controllerbindung; moderne CPUs bewältigen RAID-Berechnungen meist ohne problematische Last. | Boot- und Recovery-Konzept müssen zur Plattform passen. Funktionen und Verwaltung hängen vom Betriebssystem ab. |
| Hardware-RAID | Dedizierter Controller stellt Virtual Drives bereit und verwaltet Laufwerke, Cache, Patrol Read, Rebuild und Hot Spares. | Betriebssystemunabhängige Abstraktion, geschützter Write-Back-Cache und zentrale Laufwerksverwaltung möglich. | Zusätzliche Kosten und Abhängigkeit von Controller, Firmware, Metadatenformat und Ersatzhardware. |
| Firmware-/Host-RAID | Firmware stellt ein RAID-Metadatenformat bereit; ein Betriebssystemtreiber erledigt wesentliche Arbeit. | Kann den Systemstart und einfache Plattformkonfiguration vereinfachen. | Wird oft als Fake-RAID bezeichnet; portabler und leistungsfähiger ist es nicht automatisch. Treiber- und Plattformbindung beachten. |
| Storage-Appliance / verteiltes Storage | NAS, SAN oder Cluster verteilen Daten und Redundanz über Laufwerke, Knoten oder Standorte. | Zusätzliche Integritäts-, Snapshot-, Replikations- und Skalierungsfunktionen möglich. | Nicht jedes verteilte Verfahren ist klassisches RAID. Fehlerdomänen und Quorum müssen separat geplant werden. |
Grundbegriffe eines RAID-Verbunds
| Begriff | Bedeutung |
|---|---|
| Physical Drive | Physischer Datenträger, beispielsweise HDD, SATA-SSD oder NVMe-SSD. |
| Drive Group / Array | Gruppe physischer Datenträger, aus der ein oder mehrere logische Laufwerke entstehen können. Die genaue Bezeichnung ist herstellerspezifisch. |
| Virtual Drive / Logical Drive | Vom Controller oder Storage-Stack bereitgestelltes logisches Blockgerät. Darauf können Partitionen, Dateisysteme oder weitere Storage-Schichten liegen. |
| Strip / Chunk | Zusammenhängende Datenmenge, die auf einen einzelnen Datenträger eines Stripes geschrieben wird. Hersteller verwenden „Stripe Size“ teilweise abweichend für diese Größe. |
| Full Stripe | Zusammengehörige Chunks über alle Datenpositionen einer Stripe-Zeile. Bei Paritäts-RAID kommen zusätzlich Paritätsblöcke hinzu. |
| Stripe Width | Anzahl der am Stripe beteiligten Datenträger beziehungsweise Datenpositionen; die genaue Zählweise muss zur Dokumentation des Systems passen. |
| Mirror | Identische Nutzdatenkopie auf einem weiteren Datenträger oder innerhalb eines Spiegelpaares. |
| Parity | Berechnete Redundanzinformation, mit der fehlende Daten innerhalb der vorgesehenen Ausfalltoleranz rekonstruiert werden. |
| Degraded | Verbund ist noch verfügbar, besitzt aber nicht mehr seine vollständige Redundanz. |
| Rebuild | Rekonstruktion fehlender Daten auf einen Ersatzdatenträger. Währenddessen sind Leistung und Ausfallsicherheit reduziert. |
| Hot Spare | Bereitstehender Ersatzdatenträger, den Controller oder Software bei einem Ausfall automatisch in den Verbund einbinden können. |
Striping, Spiegelung und verteilte Parität
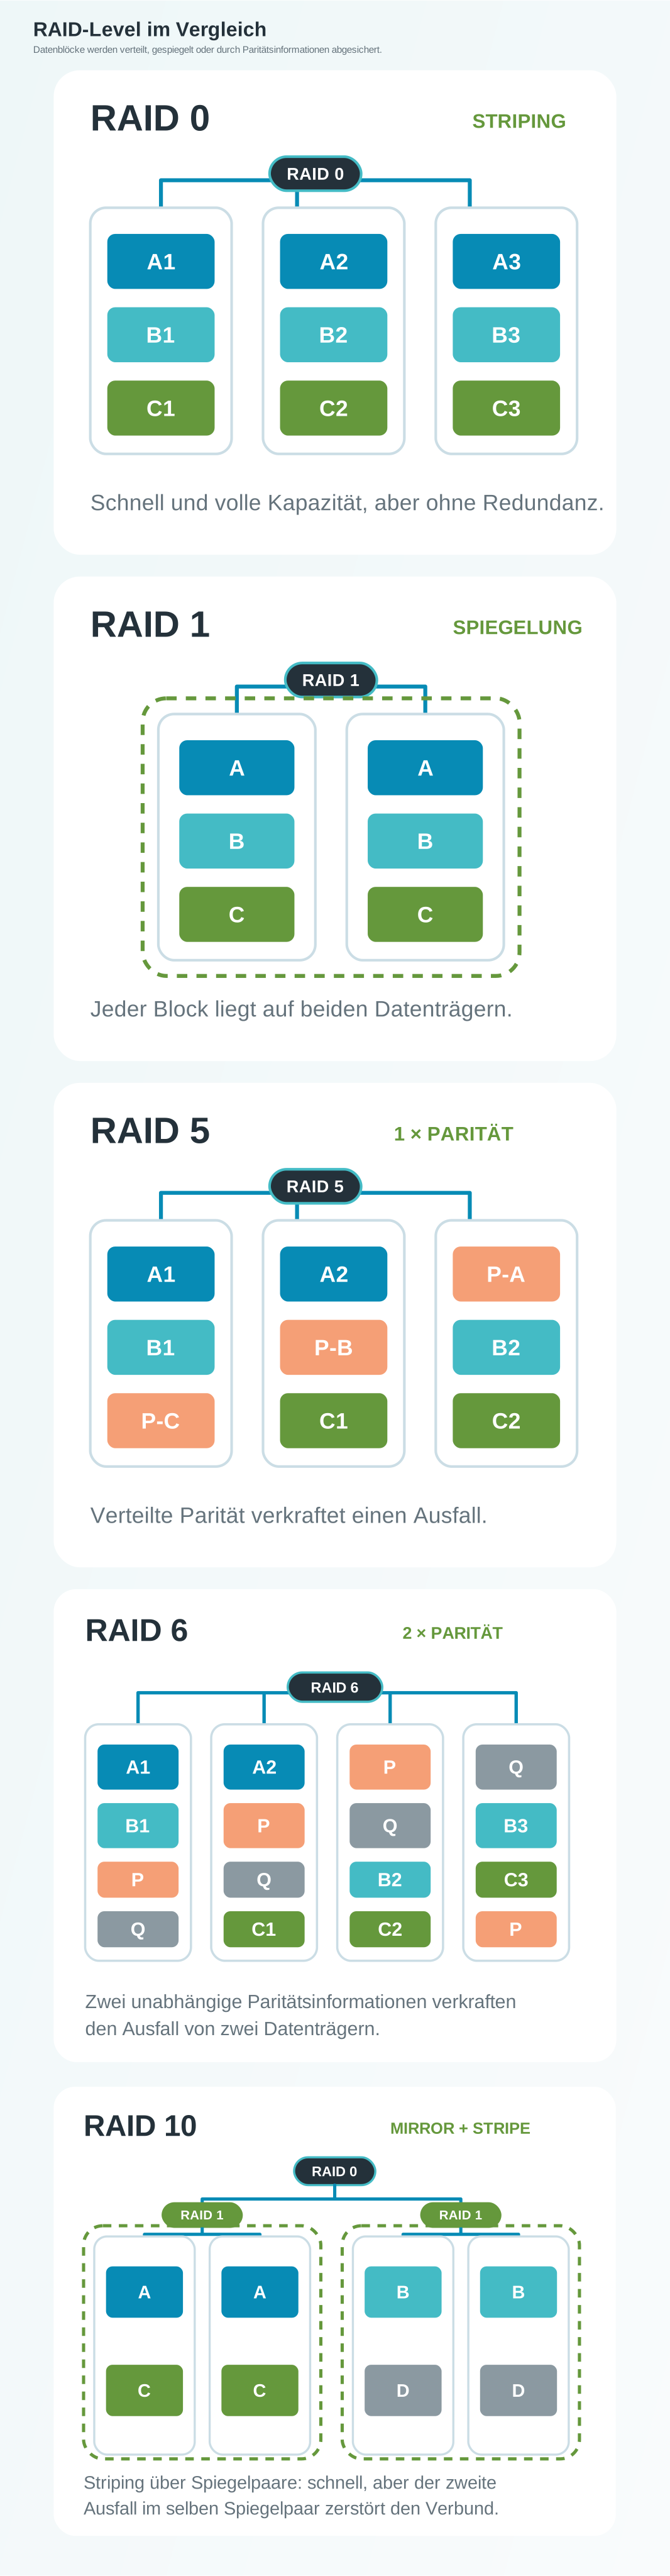
Striping verteilt aufeinanderfolgende Datenblöcke über mehrere Datenträger und ermöglicht parallele Zugriffe. Spiegelung schreibt dieselben Daten auf mehrere Mitglieder. Paritäts-RAID speichert neben den Daten berechnete Redundanzblöcke. RAID 5 verteilt eine Paritätsinformation, RAID 6 zwei voneinander unabhängige Paritätsinformationen über die Mitglieder, damit kein einzelner Paritätsdatenträger zum dauerhaften Engpass wird.
Die Grafik zeigt das Prinzip, nicht jedes mögliche Layout. Controller und Software können Paritätsrotation, Datenreihenfolge, Chunk-Größe und RAID-10-Anordnung unterschiedlich umsetzen. Metadaten und Layout müssen deshalb bei einer Wiederherstellung bekannt sein.
Parität mit XOR nachvollziehen
Bei einer einfachen XOR-Parität wird jedes Bit der Datenblöcke miteinander verknüpft. XOR liefert 1, wenn an einer Stelle eine ungerade Zahl von Einsen vorliegt. Kennt man alle übrigen Datenblöcke und die Parität, lässt sich genau ein fehlender Block rekonstruieren. RAID 6 verwendet zusätzlich eine zweite, mathematisch unabhängige Redundanzinformation; eine bloße zweite identische XOR-Parität würde keinen zweiten Ausfall absichern.
Parität aus drei Datenblöcken
P = A XOR B XOR CA = 01010010
B = 11101011
C = 11001101
P = 01110100
Fehlenden Datenblock B rekonstruieren
B = A XOR C XOR P01010010 XOR 11001101 XOR 01110100
= 11101011
Damit ist der ursprüngliche Block B wiederhergestellt.
Die gebräuchlichen RAID-Level
N ist die Zahl der Mitglieder und S die Kapazität des kleinsten verwendeten Datenträgers. Bei unterschiedlich großen Medien bleibt ohne herstellerspezifische Erweiterungen Kapazität oberhalb von S häufig ungenutzt. Angezeigte Nutzkapazität wird zusätzlich durch Controller-Metadaten, Dateisystem und die Unterscheidung von GB und GiB beeinflusst.
| Level | Mindestzahl | Nutzkapazität bei gleich großen Medien | Ausfalltoleranz | Typische Eigenschaften |
|---|---|---|---|---|
| JBOD / Linear | 1 beziehungsweise 2 für Verkettung | Summe der Kapazitäten | Keine | Kein RAID-Level. Einzelne oder verkettete Datenträger ohne Redundanz; unterschiedliche Größen möglich. |
| RAID 0 | 2 | N × S | Keine | Striping; hohe sequentielle Leistung und volle Kapazität, aber Ausfall eines Mitglieds zerstört den gesamten Verbund. |
| RAID 1 | 2 | S bei Zweiwegspiegelung | Ein Mitglied der Spiegelgruppe; bei Mehrfachspiegelung entsprechend mehr | Sehr einfache Redundanz, gute Leseleistung möglich, jeder Datenblock wird vollständig gespiegelt. |
| RAID 5 | 3 | (N - 1) × S | 1 Datenträger | Verteilte einfache Parität; gute Leseleistung, Schreibaufwand durch Daten- und Paritätsaktualisierung. |
| RAID 6 | 4 | (N - 2) × S | 2 Datenträger | Zwei unabhängige verteilte Paritäten; höhere Sicherheit bei langen Rebuilds, zusätzlicher Schreibaufwand. |
| RAID 10 | 4 | N ÷ 2 × S bei Zweiwegspiegeln | Mindestens 1; mehrere nur bei unterschiedlichen Spiegelpaaren | Striping über Spiegelpaare; gute Lese- und Schreibleistung, schnelle Rekonstruktion, aber 50 Prozent Kapazität bei Zweiwegspiegelung. |
Historische und verschachtelte RAID-Level
RAID 2 verteilte Daten bitweise und verwendete Hamming-Code, RAID 3 arbeitete byteweise mit einem dedizierten Paritätsdatenträger und RAID 4 blockweise ebenfalls mit dedizierter Parität. Diese Level sind im allgemeinen Serverbetrieb ungebräuchlich. Moderne Laufwerke besitzen eigene Fehlerkorrektur, während RAID 5 und 6 den dauerhaften Engpass einer einzelnen Paritätsplatte durch rotierende Parität vermeiden.
Verschachtelte Level kombinieren mehrere Gruppen. RAID 10 ist ein Stripe über Spiegelpaare; RAID 01 spiegelt zwei Stripe-Sets und besitzt ungünstigere Fehlerdomänen. RAID 50 verteilt Daten über mehrere RAID-5-Gruppen, RAID 60 über mehrere RAID-6-Gruppen. Die Ausfalltoleranz hängt dann davon ab, in welchen Untergruppen die Defekte auftreten. Bezeichnungen wie RAID 00, 05, 5E, 5EE, RAID 7 oder RAID n können hersteller- oder produktspezifisch sein und müssen anhand der konkreten Dokumentation bewertet werden.
| Level | Aufbau | Wichtige Konsequenz |
|---|---|---|
| RAID 01 | Spiegelung kompletter RAID-0-Sets | Nach einem Ausfall ist ein ganzes Stripe-Set betroffen; meist weniger robust als RAID 10. |
| RAID 10 | Striping über RAID-1-Spiegelpaare | Mehrere Ausfälle sind möglich, solange nicht beide Mitglieder desselben Spiegelpaares ausfallen. |
| RAID 50 | Striping über mindestens zwei RAID-5-Gruppen | Je Gruppe darf ein Mitglied ausfallen; gute Kapazität und Parallelität, aber Paritäts-Rebuild bleibt kritisch. |
| RAID 60 | Striping über mindestens zwei RAID-6-Gruppen | Je Gruppe dürfen zwei Mitglieder ausfallen; höhere Redundanz bei mehr Kapazitäts- und Schreibaufwand. |
RAID-Level passend auswählen
Die Auswahl ist ein Kompromiss aus nutzbarer Kapazität, Anschaffungskosten, gewünschter Verfügbarkeit, Wiederherstellungszeit und Leistung. Pauschale Ranglisten sind irreführend: Kleine zufällige Schreibzugriffe, große sequenzielle Transfers, Virtualisierung, Datenbanken und Archivdaten stellen unterschiedliche Anforderungen. Auch die Anzahl der Laufwerke, SSD- oder HDD-Technik, Queue-Tiefe und Controller-Cache verändern das Ergebnis.
- Herstellerfreigaben für Laufwerkstyp, Firmware, Schnittstelle, Sektorformat und maximale Mitgliederzahl prüfen.
- Rebuild-Dauer, URE-/Medienfehler-Risiko und reduzierte Leistung im degradierten Zustand einplanen.
- Keine pauschale Mischung aus HDD und SSD oder unterschiedlich schnellen Laufwerken vornehmen.
- Backup-, Restore-, Monitoring- und Ersatzteilkonzept vor der Inbetriebnahme festlegen.
| Priorität | Naheliegende Level | Einordnung |
|---|---|---|
| Maximale Leistung ohne Redundanz | RAID 0 | Nur für reproduzierbare oder anderweitig geschützte Daten; ein Ausfall betrifft den gesamten Verbund. |
| Einfache Redundanz und schnelle Wiederherstellung | RAID 1 | Geeignet für kleine Verbünde; Kapazitätswirkungsgrad bei Zweiwegspiegelung 50 Prozent. |
| Kapazität mit einfacher Redundanz | RAID 5 | Für passende Workloads und begrenzte Verbundgrößen; während eines Rebuilds besteht keine Reserve für einen weiteren Ausfall. |
| Zwei Ausfälle tolerieren | RAID 6 | Für größere HDD-Verbünde oft sinnvoller als RAID 5; Schreibaufwand und Rebuild-Fenster berücksichtigen. |
| Hohe gemischte Leistung und Redundanz | RAID 10 | Gute Wahl für latenzkritische, schreibintensive Workloads, benötigt jedoch mehr Rohkapazität. |
| Große skalierte Gruppen | RAID 50 / RAID 60 | Fehlerdomänen und Gruppengröße bewusst planen; Ausfälle pro Untergruppe betrachten. |
Cache, Schreibstrategien und Stromausfallschutz
Write Through bestätigt einen Schreibvorgang erst, nachdem die Daten auf den Zielmedien beziehungsweise in einer abgesicherten Schicht angekommen sind. Write Back bestätigt früher und kann deutlich schneller sein, benötigt aber nichtflüchtig geschützten Cache, beispielsweise CacheVault/Flash-Backup und eine funktionsfähige Energiequelle. Die historische Einstellung „Write Back trotz fehlender BBU“ riskiert bei Stromausfall bestätigte, aber noch nicht dauerhaft geschriebene Daten und darf nicht als normale Empfehlung übernommen werden.
Read Ahead kann bei vorhersagbaren sequenziellen Zugriffen helfen, bei zufälligen Zugriffen oder SSDs aber nutzlos beziehungsweise nachteilig sein. Adaptive Verfahren beobachten das Zugriffsmuster. Direct I/O und Cached I/O bezeichnen herstellerspezifische Wege zwischen Host, Controller-Cache und Medien; ihre Bedeutung ist im jeweiligen Handbuch zu prüfen.
| Funktion | Nutzen | Betriebsanforderung |
|---|---|---|
| Write Through | Hohe Sicherheit ohne flüchtige Bestätigung | Kann langsamer sein; tatsächliche Persistenz des Laufwerks und dessen Cache beachten. |
| Write Back | Bündelt und beschleunigt Schreibzugriffe | Nur mit wirksamem Cache-Schutz, Alarmierung und regelmäßig geprüftem Zustand. |
| Read Ahead | Lädt erwartete Folgeblöcke vor | Nur für passende sequenzielle Zugriffsmuster aktivieren und messen. |
| Patrol Read / Scrub | Liest Medien regelmäßig und erkennt latente Fehler vor einem Rebuild | Zeitplan, Priorität und Ergebnisüberwachung einrichten. |
| Background Initialization / Consistency Check | Initialisiert beziehungsweise prüft Spiegel- und Paritätskonsistenz | Leistungswirkung und Wartungsfenster berücksichtigen. |
| SSD-Cache / CacheCade | Häufig gelesene oder geschriebene Daten auf schnellerem Medium puffern | Lizenz, Schreibfestigkeit, Ausfallschutz und Cache-Kohärenz des Produkts prüfen. |
Betrieb, Ausfall und Rebuild
Ein Rebuild liest große Teile aller verbliebenen Mitglieder und belastet Medien sowie Anwendungen. Bei großen HDDs kann dies viele Stunden oder Tage dauern. RAID 6 oder kleinere Fehlerdomänen können das Risiko eines zweiten Fehlers reduzieren, ersetzen aber auch hier kein Backup. Ein absichtlich simulierter Ausfall darf ausschließlich in einem isolierten Labor mit entbehrlichen Daten erfolgen.
Controller, Virtual Drives, physische Medien, Cache-Schutz, Temperatur, Fehlerzähler und Ereignisprotokolle zentral überwachen.
Gehäuse, Slot, Seriennummer, WWN und LED-Kennung prüfen. Niemals allein nach wechselnden Gerätenamen austauschen.
Vor Rebuild oder Umbau kontrollieren, ob aktuelle, lesbare und getestete Sicherungen vorhanden sind.
Kompatibles Medium mit ausreichender Kapazität verwenden; Hot Spare oder Replace-/Copyback-Verfahren gemäß Hersteller anwenden.
Fortschritt, neue Medienfehler, Temperatur und Anwendungsleistung überwachen. Der Verbund ist währenddessen besonders gefährdet.
Nach Abschluss optimalen Zustand, Patrol Read/Scrub, Dateisystem, Anwendungen und Backup erneut prüfen.
Linux-Verwaltung kompakt
Unter Linux stehen für Software-RAID vor allem der Kernel-MD-Treiber mit mdadm sowie Device Mapper RAID zur Verfügung. Hardware-Controller werden mit dem jeweiligen Herstellerwerkzeug, einer Weboberfläche, Redfish/IPMI-Integration oder der UEFI-Konfiguration verwaltet. Für aktuelle Broadcom/LSI-Controller ist StorCLI beziehungsweise StorCLI2 üblich; MegaCLI ist ein Legacy-Werkzeug. Adaptec/Microchip stellt ARCCONF bereit.
Im Unterricht reicht die sichere Statuskontrolle. Kommandos zum Löschen, Erstellen, Offline-Schalten oder erzwungenen Zusammenbauen eines Arrays sind produktverändernd und gehören in ein vorbereitetes Labor sowie in die zum konkreten Controller passende Dokumentation. Vollständige MegaCLI-/ARCCONF-Konfigurationen und unkontrollierte dd-Messreihen eignen sich nicht als allgemeine Anleitung.
- Statusausgaben und Ereignisse zuerst sichern, bevor Änderungen vorgenommen werden.
- Werkzeugversion muss zu Controllerfamilie und Firmware passen.
- Cache- und RAID-Policies nicht aus alten Beispielen übernehmen, sondern anhand von Workload und Schutzmechanismen festlegen.
- dd ist kein vollständiger Storage-Benchmark; Seiten-Cache, Datenquelle, Blockgröße, Synchronisation und Zielmedium können Ergebnisse massiv verfälschen.
| Aufgabe | Typische Möglichkeit | Beispiel zur lesenden Kontrolle |
|---|---|---|
| Linux Software-RAID | mdadm, /proc/mdstat und sysfs | cat /proc/mdstat; mdadm --detail /dev/md0 |
| Broadcom/LSI Hardware-RAID | StorCLI / StorCLI2; ältere Systeme MegaCLI | storcli /c0 show; storcli /c0 /vall show |
| Adaptec/Microchip Hardware-RAID | ARCCONF | arcconf getconfig 1 |
| Einzellaufwerke | smartctl beziehungsweise nvme-cli, sofern der Controller die Daten durchreicht | smartctl -a /dev/sdX; nvme smart-log /dev/nvme0 |
| Leistungsmessung | fio mit dokumentiertem Blockprofil, Queue-Tiefe, Laufzeit und direktem I/O | Messung nur auf einem ausdrücklich dafür vorgesehenen Testziel; niemals ungeprüft auf Produktivgeräten. |
Windows und Controller-Verwaltung kompakt
Unter Windows und Windows Server stellt Storage Spaces mehrere physische Datenträger als Speicherpool zusammen. Daraus entstehen virtuelle Datenträger mit einfacher, gespiegelter oder paritätsbasierter Resilienz. Storage Spaces Direct erweitert dieses Prinzip auf mehrere Server eines Clusters. Für Verwaltung und Überwachung stehen je nach Umgebung die Einstellungen beziehungsweise Systemsteuerung, Windows Admin Center, Server-Manager, Failovercluster-Manager und die PowerShell-Storage-Cmdlets zur Verfügung.
Ein Hardware-RAID-Controller arbeitet unterhalb des Betriebssystems. Windows sieht häufig nur das vom Controller bereitgestellte logische Laufwerk. Datenträgerverwaltung, Get-Disk oder SMART-Werte allein zeigen dann nicht zuverlässig den Zustand aller physischen Mitglieder, des Controller-Caches oder eines laufenden Rebuilds. Dafür sind das freigegebene Herstellerwerkzeug, die Managementoberfläche des Servers oder Controllers und dessen Ereignisprotokoll maßgeblich.
- Storage Spaces, dynamische Datenträger und ein Hardware-RAID sind unterschiedliche Techniken und dürfen nicht gleichgesetzt werden.
- Vor Änderungen die Zuordnung aus physischem Laufwerk, Slot, Seriennummer, Speicherpool beziehungsweise Array und virtuellem Datenträger dokumentieren.
- PowerShell-Cmdlets und Herstellerwerkzeuge als Administrator nur auf dem vorgesehenen System ausführen; zunächst ausschließlich Statusinformationen lesen.
- Treiber, Firmware, Verwaltungswerkzeug und Controllerfamilie müssen zueinander passen. Warnungen im Windows-Ereignisprotokoll ergänzen, aber ersetzen nicht die Controllerdiagnose.
| Aufgabe | Typische Möglichkeit | Beispiel zur lesenden Kontrolle |
|---|---|---|
| Windows Storage Spaces | Windows Admin Center, Server-Manager oder PowerShell-Modul Storage | Get-StoragePool; Get-VirtualDisk; Get-PhysicalDisk |
| Storage Spaces Direct | Windows Admin Center, Failovercluster-Manager und PowerShell | Get-Cluster; Get-StorageHealthAction; Get-VirtualDisk |
| Windows-Datenträgeransicht | Datenträgerverwaltung, Get-Disk und Get-Volume | Get-Disk; Get-Volume |
| Broadcom/LSI Hardware-RAID | StorCLI / StorCLI2 für die unterstützte Controllerfamilie | storcli /c0 show; storcli /c0 /vall show |
| Adaptec/Microchip Hardware-RAID | ARCCONF für die unterstützte Controllerfamilie | arcconf getconfig 1 |
| Server- und Controller-Management | Herstelleroberfläche, BMC/Redfish, Ereignisprotokoll oder UEFI-Konfiguration | Zustand von Array, physischen Laufwerken, Cache-Schutz, Hot Spare und Rebuild kontrollieren. |
Quellen zur fachlichen Prüfung
- Linux Kernel: RAID arrays und MD-Zustände
- Linux Kernel: Device Mapper RAID, Level, Chunk-Größe und Rebuild
- Linux Kernel: RAID-4/5/6-Cache und Write-Hole
- Red Hat: Software-RAID mit mdadm verwalten
- Microsoft Learn: Storage Spaces unter Windows Server
- Microsoft Learn: Storage Spaces Direct - Aufbau und Verwaltungswerkzeuge
- Broadcom: StorCLI MR 8.2 und unterstützte RAID-Level
- Broadcom: CacheVault und Cache-Policies
- Microchip: ARCCONF Command Line Utility User Guide
PDF-Download nach Anmeldung
Zum Schutz der Unterrichtsunterlagen steht der PDF-Download ausschließlich angemeldeten Nutzern zur Verfügung.