
6.2 Presentation Layer
Die Darstellungsschicht ist Schicht 6 des OSI-Referenzmodells. Sie beschreibt, wie unterschiedliche Systeme Daten in eine gemeinsam verstandene Darstellung überführen. Dazu gehören Syntax, Zeichencodierung, Serialisierung, Zahlen- und Byteanordnung, Kompression sowie der Schutz übertragener Daten. In heutigen TCP/IP-Anwendungen liegen diese Aufgaben meist in Datenformaten, Bibliotheken, Medien-Codecs, Anwendungsprotokollen und TLS.
Syntax, Semantik und gemeinsame Darstellung
Syntax beschreibt den formalen Aufbau von Daten, Semantik ihre Bedeutung. Zwei Systeme können dieselbe Information intern unterschiedlich speichern und trotzdem kommunizieren, wenn das Übertragungsformat eindeutig festlegt, wie Werte codiert, angeordnet und interpretiert werden. Die Darstellung darf sich ändern, der beabsichtigte Bedeutungsinhalt muss erhalten bleiben.
Eine reine Bytefolge erklärt sich nicht selbst. Sender und Empfänger benötigen Vereinbarungen über Datentypen, Feldreihenfolge, Länge, Zeichencodierung, Zahlenformat, Version und zulässige Werte. Ein formal korrektes Dokument kann trotzdem fachlich ungültig sein, wenn beispielsweise ein Pflichtfeld fehlt oder ein Wert außerhalb des erlaubten Bereichs liegt.
| Ebene der Prüfung | Frage | Beispiel |
|---|---|---|
| Syntax | Entspricht die Byte- oder Textfolge den Grammatikregeln? | JSON-Klammern und Zeichenfolgen sind korrekt aufgebaut. |
| Struktur | Sind erwartete Felder und Datentypen vorhanden? | Die Eigenschaft „port“ enthält eine Ganzzahl. |
| Semantik | Hat der Wert im Anwendungsfall eine zulässige Bedeutung? | Der Port liegt zwischen 0 und 65535. |
Vom Datenobjekt zur Übertragung und zurück
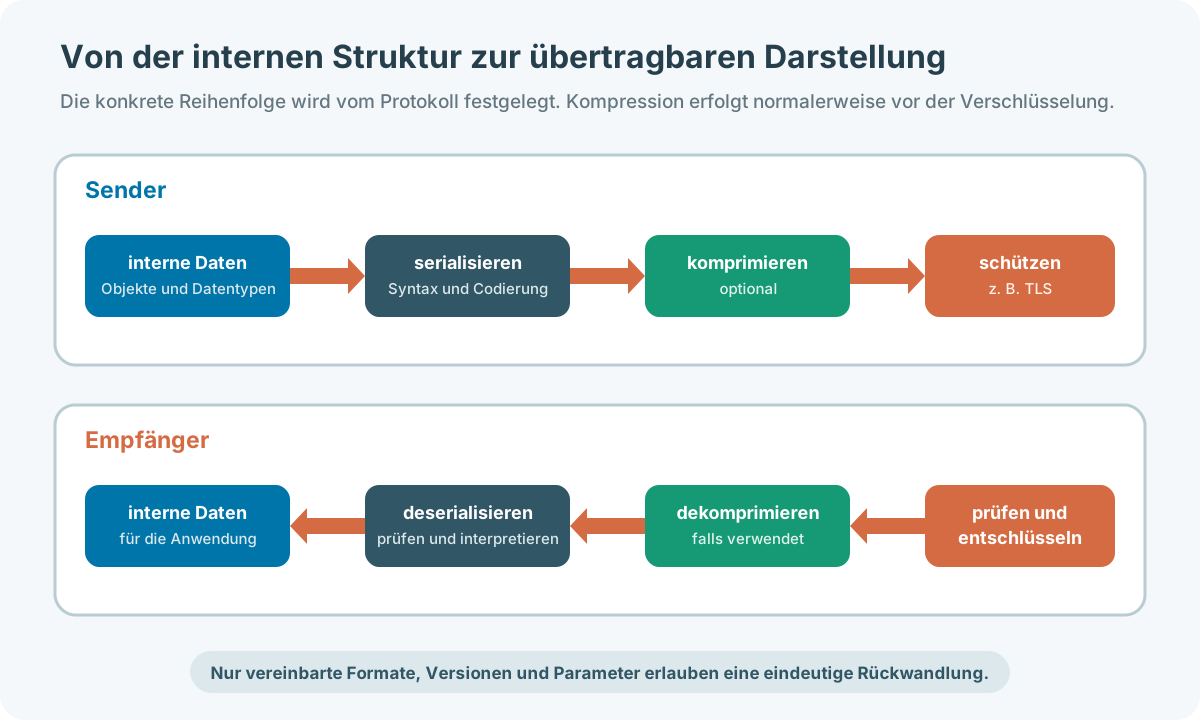
Serialisierung wandelt interne Objekte und abstrakte Datentypen in eine übertragbare Bytefolge um. Deserialisierung prüft und rekonstruiert daraus eine für die Zielanwendung nutzbare Struktur. Dabei dürfen empfangene Daten niemals ungeprüft als vertrauenswürdig gelten.
Kompression wird gewöhnlich vor der Verschlüsselung durchgeführt. Gut verschlüsselte Daten wirken statistisch nahezu zufällig und lassen sich anschließend kaum sinnvoll komprimieren. Welche Schritte tatsächlich vorkommen und in welcher Reihenfolge sie ausgeführt werden, legt das konkrete Protokoll fest.
Zeichen, Unicode und UTF-8
Ein Zeichen ist nicht dasselbe wie ein Byte. Unicode ordnet Zeichen abstrakte Codepoints zu; eine Codierung wie UTF-8 legt fest, wie diese Codepoints als Bytes dargestellt werden. UTF-8 verwendet je nach Codepoint unterschiedlich viele Bytes und ist mit ASCII für dessen Zeichenbereich kompatibel.
Fehler entstehen, wenn Bytes mit der falschen Zeichencodierung interpretiert werden oder wenn Anwendungen unterschiedlich mit Normalisierungsformen umgehen. Deshalb müssen Protokolle die erwartete Codierung eindeutig festlegen. Längenangaben müssen außerdem unterscheiden, ob Bytes, Codepoints oder angezeigte Zeichen gemeint sind.
| Begriff | Bedeutung |
|---|---|
| Codepoint | abstrakte Unicode-Nummer eines Zeichens oder Zeichenelements |
| UTF-8 | variable Bytecodierung für Unicode-Codepoints |
| Graphem | für Benutzer sichtbare Einheit; kann aus mehreren Codepoints bestehen |
| Normalisierung | vereinheitlicht unterschiedliche, aber äquivalente Codepointfolgen |
| Mojibake | unleserliche Darstellung durch falsche Interpretation der Bytes |
Zahlen, Byte-Reihenfolge und Datentypen
Rechnersysteme können mehrbyteige Zahlen intern unterschiedlich anordnen. Bei Big Endian steht das höchstwertige Byte zuerst, bei Little Endian das niedrigstwertige. Viele Internetprotokolle verwenden die Network Byte Order, also Big Endian. Ein Übertragungsformat muss die Reihenfolge ausdrücklich festlegen oder vollständig durch seine Codierungsregeln bestimmen.
Auch Ganzzahlbreite, Vorzeichen, Fließkommadarstellung, Rundung, Datumsformat und Zeitzone sind Teil der Darstellung. Eine direkte Übertragung interner Speicherstrukturen ist deshalb nicht portabel: Padding, Architektur, Compiler und Programmiersprache können die interne Repräsentation verändern.
| Problem | Notwendige Vereinbarung |
|---|---|
| 16-, 32- oder 64-Bit-Zahl | Breite und Vorzeichen |
| mehrbyteige Ganzzahl | Byte-Reihenfolge |
| Fließkommazahl | Format, Genauigkeit und Umgang mit Sonderwerten |
| Zeitangabe | Format, Zeitzone und Genauigkeit |
| optionales Feld | Kennzeichnung, Standardwert und Versionsverhalten |
Textuelle und binäre Serialisierungsformate
Textformate sind häufig leicht lesbar und gut mit Standardwerkzeugen zu untersuchen. Binärformate können kompakter sein und Datentypen direkter abbilden, benötigen aber passende Decoder. Die Wahl hängt von Interoperabilität, Datenmenge, Rechenaufwand, Schemaanforderungen und Fehlersuche ab.
ASN.1 ist eine formale Notation zur Beschreibung abstrakter Datentypen. Konkrete Encoding Rules wie BER, DER oder PER bestimmen daraus die Bytes. ASN.1 ist weiterhin in Bereichen wie Zertifikaten und Telekommunikation relevant. Daneben sind heute JSON, XML, CBOR und schemaorientierte binäre Formate verbreitet.
| Format / Konzept | Darstellung | Typische Stärke |
|---|---|---|
| JSON | textuell | breite Unterstützung und gute Lesbarkeit |
| XML | textuell | Namensräume, Schemas und dokumentorientierte Strukturen |
| CBOR | binär | kompakte, erweiterbare Darstellung auch für eingeschränkte Systeme |
| ASN.1 mit Encoding Rules | abstraktes Schema plus definierte Binärcodierung | präzise Typen und standardisierte Codierungsvarianten |
| Protocol Buffers | schemaorientiert binär | kompakte Nachrichten und Codegenerierung |
Verlustfreie Kompression
Verlustfreie Kompression ermöglicht die exakte Rekonstruktion der ursprünglichen Daten. Sie ist für Programme, Dokumente, Datenbanken und andere Inhalte erforderlich, bei denen kein Informationsverlust akzeptabel ist. Der erreichbare Gewinn hängt von Wiederholungen und statistischen Eigenschaften der Daten ab.
Lauflängencodierung ersetzt längere Folgen gleicher Werte durch Wert und Anzahl. Huffman-Codierung ordnet häufigen Symbolen kürzere und seltenen Symbolen längere Bitmuster zu. Arithmetische Codierung beschreibt eine gesamte Symbolfolge als Bereich. Wörterbuch- und Substitutionsverfahren ersetzen wiederkehrende Muster durch Referenzen. Praktische Formate kombinieren häufig mehrere Verfahren.
| Verfahren | Grundidee | Geeignet, wenn |
|---|---|---|
| RLE | Folgen gleicher Werte als Wert plus Anzahl speichern | lange Wiederholungen vorkommen |
| Huffman | variable Codelängen nach Häufigkeit | Symbolhäufigkeiten ungleich verteilt sind |
| arithmetische Codierung | Symbolfolge als Wahrscheinlichkeitsintervall darstellen | feine Wahrscheinlichkeitsmodelle genutzt werden |
| Wörterbuchverfahren | wiederkehrende Muster referenzieren | Text oder strukturierte Daten viele Wiederholungen enthalten |
Verlustbehaftete Medienkompression
Verlustbehaftete Verfahren entfernen Informationen, die für den vorgesehenen Wahrnehmungs- oder Qualitätszweck als weniger wichtig bewertet werden. Das Original lässt sich nicht exakt zurückgewinnen. Dafür können Bild-, Audio- und Videodaten deutlich stärker verkleinert werden. Qualität, Bitrate, Auflösung, Bildrate und Latenz müssen zum Einsatzgebiet passen.
Prädiktive Verfahren codieren Abweichungen von einer Vorhersage. Transformationsverfahren überführen Daten in einen anderen Wertebereich, in dem weniger wichtige Anteile gröber quantisiert oder entfernt werden können. Viele Medien-Codecs kombinieren Prädiktion, Transformation, Quantisierung und Entropiecodierung.
| Bereich | Historische Beispiele | Heute verbreitete Beispiele |
|---|---|---|
| Einzelbilder | JPEG | JPEG, PNG verlustfrei, WebP und AVIF |
| Video | MPEG-1/2, H.261 und p×64 | H.264/AVC, H.265/HEVC, VP9 und AV1 |
| Audio | DVI/IMA ADPCM und frühe MPEG-Audioverfahren | AAC, Opus und FLAC verlustfrei |
Kryptografie: drei Schutzziele unterscheiden
Verschlüsselung schützt die Vertraulichkeit, also den Inhalt vor unberechtigtem Lesen. Sie beweist allein weder, dass Daten unverändert sind, noch wer sie gesendet hat. Moderne gesicherte Verbindungen kombinieren Verschlüsselung mit Integritäts- und Authentisierungsmechanismen.
TLS 1.3 schützt Anwendungsprotokolle während der Übertragung und wird praktisch häufig zwischen Anwendungs- und Transportschicht eingeordnet. Die Anwendung muss Zertifikate, Namen, Vertrauenskette und Fehler korrekt prüfen. Kompression und Verschlüsselung dürfen nicht beliebig kombiniert werden, weil Größenunterschiede trotz Verschlüsselung Informationen über geheime Inhalte verraten können.
| Schutzziel | Bedeutung | Beispielmechanismus |
|---|---|---|
| Vertraulichkeit | Unbefugte sollen den Inhalt nicht lesen. | Verschlüsselung |
| Integrität | Unbemerkte Veränderungen sollen erkannt werden. | authentisierte Verschlüsselung oder MAC |
| Authentizität | Identität beziehungsweise Herkunft soll geprüft werden. | Zertifikate, Signaturen oder gemeinsam bekannte Schlüssel |
Darstellungsfehler systematisch untersuchen
| Fehlerbild | Mögliche Ursache | Prüfung |
|---|---|---|
| Umlaute erscheinen falsch | falsche Zeichencodierung | Content-Type, Charset und tatsächliche Bytes vergleichen |
| Zahl ist extrem groß oder negativ | falsche Byte-Reihenfolge, Breite oder Vorzeichen | Formatspezifikation und Hexdarstellung prüfen |
| Nachricht lässt sich nicht parsen | Syntaxfehler, falsche Version oder abgeschnittene Daten | Länge, Schema, Decoderfehler und Mitschnitt prüfen |
| Bild oder Audio ist beschädigt | falscher Codec, fehlende Daten oder unpassende Parameter | Medientyp, Container, Codec und Prüfsummen kontrollieren |
| TLS-Verbindung scheitert | Zertifikat, Name, Zeit, Version oder Cipher Suite unpassend | TLS-Handshake und Zertifikatskette analysieren |
Quellen zur fachlichen Prüfung
- ITU-T: X.216 - OSI presentation service definition
- ITU-T: X.680 - Abstract Syntax Notation One (ASN.1)
- Unicode Consortium: The Unicode Standard
- RFC Editor: RFC 8259 - The JavaScript Object Notation Data Interchange Format
- RFC Editor: RFC 8949 - Concise Binary Object Representation
- RFC Editor: RFC 8446 - The Transport Layer Security Protocol Version 1.3
PDF-Download nach Anmeldung
Zum Schutz der Unterrichtsunterlagen steht der PDF-Download ausschließlich angemeldeten Nutzern zur Verfügung.