
6.1 Prozessor - Aufbau, Arbeitsweise und Leistung
Die Central Processing Unit (CPU) führt Maschinenbefehle aus und koordiniert zentrale Verarbeitungsabläufe. Moderne Prozessoren bestehen nicht nur aus einem Rechenwerk: Sie enthalten mehrere Kerne, eine mehrstufige Cache-Hierarchie, Speicher- und häufig PCIe-Controller, Einheiten für Ganzzahl-, Gleitkomma- und Vektoroperationen sowie Funktionen für Virtualisierung, Sicherheit und Energieverwaltung. Ihre reale Leistung ergibt sich aus dem Zusammenspiel von Architektur, Software, Takt, Speicherzugriffen, Leistungsgrenzen und Kühlung.
Prozessor, Mikroprozessor, CPU und Mikrocontroller
Ein Prozessor ist eine programmierbare digitale Verarbeitungseinheit. Als Mikroprozessor wird ein Prozessor bezeichnet, dessen zentrale Verarbeitungseinheiten in einem integrierten Schaltkreis beziehungsweise heute häufig in einem gemeinsamen Gehäuse aus mehreren Dies oder Chiplets realisiert sind. CPU bezeichnet im allgemeinen Sprachgebrauch den Hauptprozessor eines Computers. Daneben können GPUs, NPUs, Signalprozessoren, Netzwerkprozessoren und Controller eigenständige Aufgaben übernehmen.
Ein Mikrocontroller kombiniert CPU-Kern, Programmspeicher, Arbeitsspeicher, Timer und digitale oder analoge Ein-/Ausgänge auf einem Baustein. Er steuert beispielsweise Sensoren, Maschinen oder Haushaltsgeräte und ist damit ein weitgehend vollständiges eingebettetes Computersystem. Ein System-on-Chip (SoC) integriert noch umfangreichere Funktionsgruppen wie CPU, GPU, NPU, Speichercontroller, Multimedia- und Funkblöcke. Die Grenzen der Begriffe überschneiden sich je nach Einsatzgebiet.
| Begriff | Kennzeichen | Typische Verwendung |
|---|---|---|
| CPU / Hauptprozessor | Allgemeine Befehlsverarbeitung und Steuerung; ein oder mehrere Kerne | Desktop, Notebook, Server, Smartphone, Embedded-System |
| Mikroprozessor | Prozessor als hochintegrierter Baustein oder Mehrchip-Package | Allgemeiner technischer Oberbegriff für viele CPUs |
| Mikrocontroller | CPU plus Speicher und Peripheriecontroller auf einem Chip | Steuerungen, Sensorik, IoT, Fahrzeuge, Maschinen |
| SoC | Mehrere vollständige Subsysteme in einem Chip oder Package | Smartphones, kompakte PCs, Konsolen, Embedded-Systeme |
| GPU / NPU / DSP | Spezialisierte Parallel- oder Signalverarbeitung | Grafik, KI, Audio, Video, wissenschaftliche Berechnungen |
Hersteller, Plattformen und Befehlssätze
Intel und AMD prägen den Markt für x86-64-Desktop-, Notebook- und Serverprozessoren. Arm-basierte Prozessoren sind in Smartphones, Embedded-Systemen und zunehmend auch in Notebooks und Servern verbreitet. Hinzu kommen unter anderem Apple, Qualcomm, IBM und Anbieter von RISC-V-Prozessoren. Arm ist dabei nicht einfach ein einzelner Prozessorhersteller, sondern stellt unter anderem Architekturen und Prozessorkern-Designs bereit, die von Lizenznehmern in eigene SoCs integriert werden können.
Der Befehlssatz, die Instruction Set Architecture (ISA), beschreibt die für Software sichtbare Schnittstelle: Befehle, Register, Datentypen, Adressierung und Privilegienstufen. Die Mikroarchitektur beschreibt, wie ein konkreter Prozessor diese ISA intern umsetzt. Unterschiedliche Mikroarchitekturen können deshalb dieselben Programme ausführen, aber bei Leistung, Energiebedarf und interner Organisation stark voneinander abweichen. Die ausführliche Gegenüberstellung folgt in 6.2.
Warum Taktfrequenz allein keine Leistung angibt
Die Taktfrequenz beschreibt, wie viele Taktzyklen pro Sekunde stattfinden. Sie sagt nicht, wie viele nützliche Befehle in jedem Zyklus abgeschlossen werden, wie lange Speicherzugriffe dauern oder wie gut ein Programm parallelisiert ist. Ein moderner Kern kann mehrere Mikrooperationen pro Takt bearbeiten, muss bei Datenabhängigkeiten, Fehlvorhersagen und Cache-Misses aber warten. Deshalb sind GHz-Werte nur innerhalb ähnlicher Architekturen und Betriebsbedingungen begrenzt vergleichbar.
MIPS und FLOPS bleiben wichtige Begriffe, sind aber keine universellen Ranglisten. MIPS hängt stark vom Befehlssatz und der Art der Befehle ab. FLOPS misst Gleitkommaoperationen und ist nur für passende Rechenlasten aussagekräftig; theoretische Spitzenwerte werden in realen Anwendungen selten vollständig erreicht. Belastbare Vergleiche verwenden reproduzierbare Benchmarks, passende Datensätze und dieselben Systembedingungen.
| Einflussgröße | Bedeutung für die reale Leistung |
|---|---|
| Taktfrequenz | Zyklen pro Sekunde; dynamisch und abhängig von Last, Temperatur, Strom- und Leistungsgrenzen. |
| IPC | Instructions per Cycle; abhängig von Mikroarchitektur und konkretem Programm. |
| Kerne und Threads | Erhöhen Durchsatz nur, wenn ausreichend unabhängige Arbeit vorhanden ist. |
| Cache und Speicher | Trefferquote, Latenz und Bandbreite entscheiden, wie oft Ausführungseinheiten auf Daten warten. |
| Befehlssatzerweiterungen | SIMD-, Kryptografie- oder Matrixbefehle beschleunigen geeignete und entsprechend programmierte Software. |
| Power und Kühlung | Bestimmen, wie lange hohe Frequenzen gehalten werden können; kurze und dauerhafte Leistung unterscheiden sich. |
| Benchmark | Muss zur vorgesehenen Arbeitslast passen; ein einzelner Wert bildet nicht alle Anwendungen ab. |
Takt, Multiplikator und dynamischer Boost
Ein Referenztakt wird intern über Taktgeneratoren und Phase-Locked Loops (PLL) vervielfacht. Das vereinfachte Rechenschema lautet Taktfrequenz = Referenztakt × Multiplikator. Bei 100 MHz Referenztakt und Multiplikator 40 ergeben sich 4,0 GHz. Moderne Prozessoren verwenden jedoch nicht einen festen Takt für das gesamte Package, sondern regeln Kerne und Funktionsblöcke abhängig von Last und Betriebsgrenzen separat.
Der Basistakt ist kein garantierter Dauertakt jeder Anwendung und der maximale Boost-Takt gilt typischerweise nur unter bestimmten Bedingungen. Anzahl aktiver Kerne, Befehlstyp, Leistungsaufnahme, Strom, Temperatur, Kühlung und Firmwareeinstellungen begrenzen den erreichbaren Takt. Übertaktung verändert Spezifikationen und kann Stabilität, Energieverbrauch, Lebensdauer und Garantie beeinflussen.
Vereinfachte Taktberechnung
f_CPU = f_Referenz × MultiplikatorReferenztakt: 100 MHz
Multiplikator: 40
100 MHz × 40 = 4.000 MHz = 4,0 GHz
Mehrkernprozessoren, SMT und hybride Kerne
Mehrkernprozessoren enthalten mehrere physische CPU-Kerne. Betriebssysteme können dadurch mehrere Threads gleichzeitig ausführen. Browser, Entwicklungsumgebungen, virtuelle Maschinen, Compiler, Rendering, Datenbanken und Hintergrunddienste profitieren heute regelmäßig von mehr als zwei Kernen. Der Geschwindigkeitsgewinn bleibt dennoch durch serielle Programmteile, Synchronisation, Speicherbandbreite und Aufgabenverteilung begrenzt.
Simultaneous Multithreading (SMT), bei Intel häufig Hyper-Threading genannt, lässt einen physischen Kern mehrere Hardwarethreads verwalten. Diese teilen sich Ausführungseinheiten und andere Ressourcen; zwei Threads entsprechen daher nicht zwei vollständigen Kernen. Hybride Prozessoren kombinieren unterschiedlich ausgelegte Kerne, beispielsweise leistungsorientierte und effizienzorientierte Kerne. Das Betriebssystem muss Threads passend planen und Eigenschaften der jeweiligen Plattform berücksichtigen.
| Begriff | Nicht verwechseln mit | Praxis |
|---|---|---|
| Physischer Kern | Hardwarethread | Besitzt eigene zentrale Ausführungsressourcen und meist private Cache-Anteile. |
| Hardwarethread / logischer Prozessor | Vollständigem zusätzlichen Kern | Nutzt freie Ressourcen eines Kerns und erhöht häufig den Durchsatz. |
| Softwarethread | Prozess | Vom Betriebssystem planbarer Ausführungsstrang innerhalb eines Prozesses. |
| Hybride Kerne | Einfach nur verschiedenen Taktraten | Können unterschiedliche Mikroarchitektur, Leistung und Energieeffizienz besitzen. |
Vom Befehl zum Ergebnis
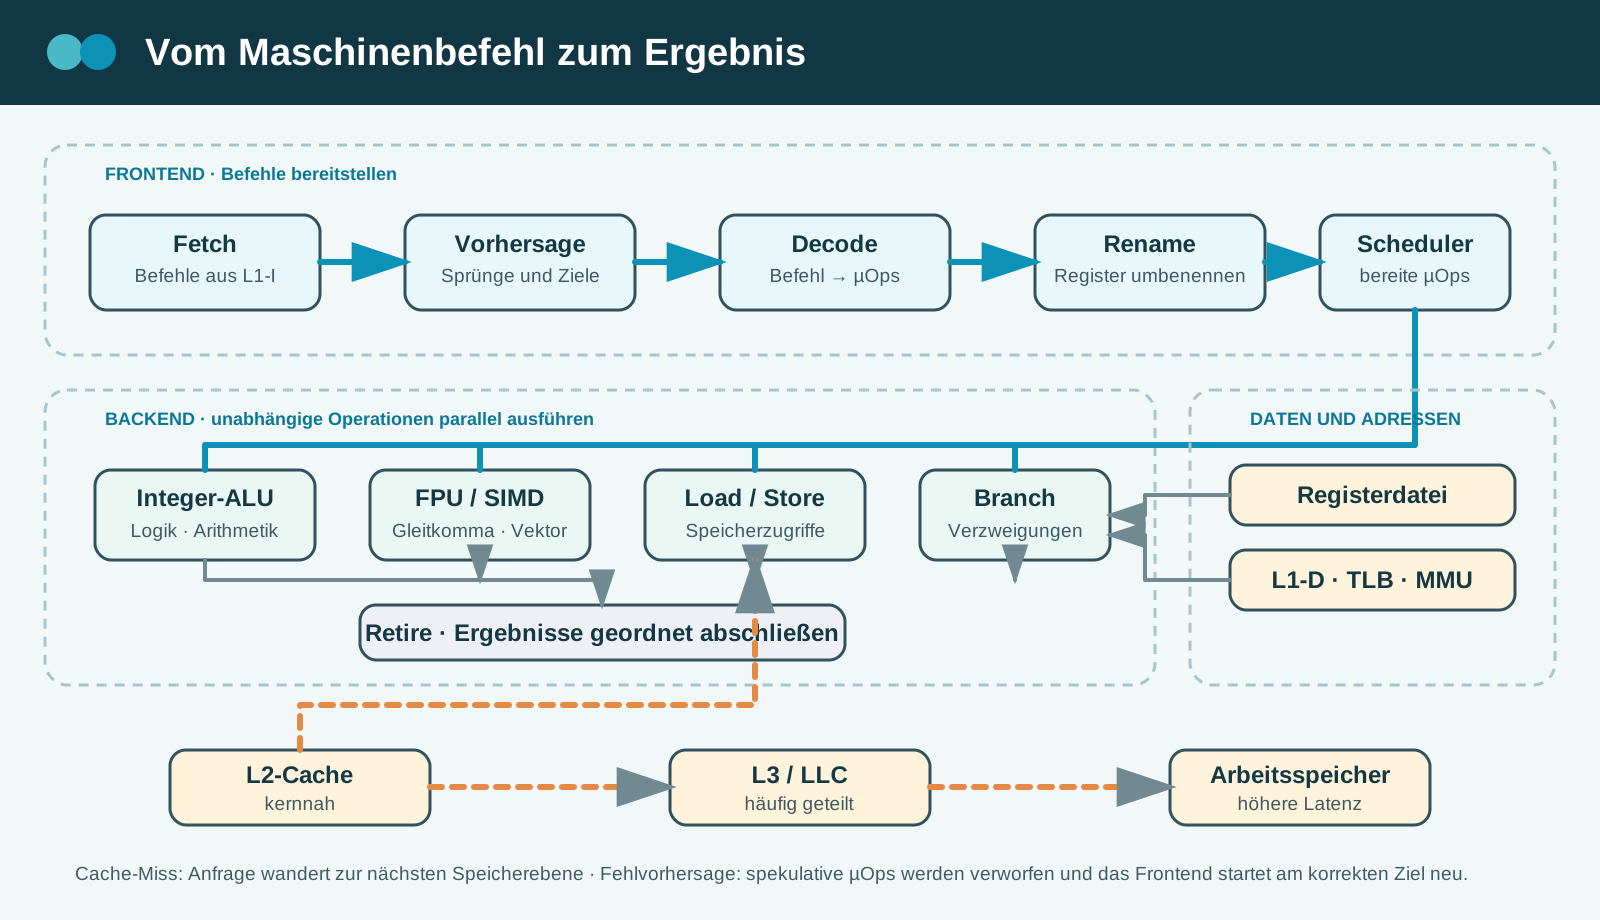
Das klassische Modell Fetch - Decode - Execute bleibt als Grundprinzip gültig. Der Befehlszähler verweist auf den nächsten Programmabschnitt. Befehle werden aus dem Speicher beziehungsweise Cache geholt, decodiert, mit Operanden versorgt, ausgeführt und ihre Ergebnisse architektonisch sichtbar gemacht. Moderne Hochleistungsprozessoren überlappen viele dieser Schritte und bearbeiten zahlreiche Befehle gleichzeitig.
Out-of-Order-Ausführung lässt unabhängige Operationen vorziehen, wenn frühere Befehle beispielsweise auf Daten warten. Registerumbenennung verhindert falsche Abhängigkeiten; Sprungvorhersage und spekulative Ausführung halten die Pipeline gefüllt. Ergebnisse werden anschließend in der korrekten Programmreihenfolge abgeschlossen. Bei einer Fehlvorhersage müssen spekulative Arbeiten verworfen werden, was Zeit und Energie kostet.
Steuerwerk, Rechenwerke und Register
Das Steuerwerk koordiniert Befehlsbereitstellung, Decodierung und Ausführung. Ein heutiger Kern enthält mehrere spezialisierte Ausführungseinheiten statt nur einer ALU. Ganzzahl-ALUs bearbeiten arithmetische und logische Operationen, Load/Store-Einheiten führen Speicherzugriffe aus und FPU-/Vektoreinheiten verarbeiten Gleitkomma- sowie SIMD-Operationen. Verzweigungseinheiten berechnen Sprungziele und Bedingungen.
Register sind der schnellste direkt von Befehlen verwendete Speicher. Dazu zählen allgemeine Register, Vektorregister, Statusinformationen und der Instruction Pointer beziehungsweise Program Counter. Der historische Akkumulator war in frühen Architekturen besonders zentral; moderne ISAs verwenden meist zahlreiche Register. Flags halten unter anderem Ergebnisse von Vergleichen, Überläufen oder Nullresultaten fest.
- ALU: Ganzzahlarithmetik, Vergleiche, Schiebe- und logische Operationen.
- FPU: Gleitkommarechnung; heute üblicherweise fest in allgemeine CPUs integriert.
- SIMD-/Vektoreinheit: verarbeitet mehrere Datenelemente mit einem Befehl.
- Load/Store: berechnet Speicheradressen und bewegt Daten zwischen Registern und Cache.
- Branch Unit: verarbeitet Verzweigungen und arbeitet mit der Sprungvorhersage zusammen.
- NPU-/Matrixeinheiten: optionale Beschleuniger für geeignete KI- und Matrixoperationen; nicht Bestandteil jeder CPU.
Cache-Hierarchie und Speicherzugriffe
Register sind extrem schnell, aber sehr klein. Cache-Speicher hält häufig benötigte Befehle und Daten näher an den Kernen. L1 ist meist in Befehls- und Datencache getrennt und besonders klein sowie schnell. L2 ist größer und häufig einem Kern zugeordnet. L3 beziehungsweise Last-Level-Cache ist größer und kann von mehreren Kernen geteilt werden. Konkrete Größen, Exklusivität und Topologie unterscheiden sich stark.
Bei einem Cache-Treffer stehen Daten schnell bereit. Bei einem Cache-Miss muss die nächste Ebene oder der Arbeitsspeicher angefragt werden. Prefetcher versuchen Zugriffe vorherzusehen. In Mehrkernsystemen sorgen Kohärenzprotokolle dafür, dass Kerne eine konsistente Sicht auf gemeinsam verwendete Speicherbereiche erhalten. Ein größerer Cache verbessert nicht jede Anwendung; Zugriffsmuster, Latenz und Bandbreite sind entscheidend.
| Ebene | Typische Eigenschaft | Aufgabe |
|---|---|---|
| Register | Wenige, direkt durch Befehle adressiert | Operanden, Adressen und Zwischenergebnisse. |
| L1 | Kleinste und schnellste Cache-Ebene | Sehr kurzfristig benötigte Befehle und Daten. |
| L2 | Größer, etwas höhere Latenz | Puffert Arbeitssätze eines Kerns oder Kernclusters. |
| L3 / LLC | Noch größer, oft geteilt | Reduziert Zugriffe auf den Arbeitsspeicher und unterstützt Datenaustausch. |
| RAM | Deutlich größer, aber höhere Latenz | Aktive Programme und Daten des Systems. |
MMU, virtueller Speicher und Speicherschutz
Die Memory Management Unit (MMU) übersetzt virtuelle in physische Adressen und prüft Zugriffsrechte. Seitentabellen werden vom Betriebssystem verwaltet; Translation Lookaside Buffers (TLBs) cachen bereits verwendete Übersetzungen. Dadurch erhält jeder Prozess einen eigenen virtuellen Adressraum, während das Betriebssystem Speicher flexibel zuordnen, teilen oder auslagern kann.
NX beziehungsweise XD markiert Speicherseiten als nicht ausführbar und ist eine Grundlage der Data Execution Prevention. Die Funktion verhindert nicht allein alle Buffer-Overflow-Angriffe, erschwert aber das direkte Ausführen eingeschleuster Daten. Moderne Schutzkonzepte kombinieren Seitenrechte mit Adressraumrandomisierung, Privilegienstufen, Kontrollfluss-Schutz und regelmäßigen Software- sowie Firmwareupdates.
Hardwarebeschleunigung und Virtualisierung
Hardwarebeschleunigung ist heute weit verbreitet. GPUs rendern Grafik und führen parallele Berechnungen aus; Videoeinheiten codieren und decodieren Medienformate; AES- und SHA-Befehle beschleunigen Kryptografie; NPUs und Matrixeinheiten bearbeiten geeignete KI-Modelle. Software benötigt passende Bibliotheken, Treiber und Codepfade und muss einen sicheren Fallback besitzen, wenn eine Funktion fehlt.
CPU-Virtualisierungserweiterungen unterstützen Hypervisoren beim Trennen und Ausführen virtueller Maschinen. Zweite Ebenen der Adressübersetzung reduzieren den Verwaltungsaufwand für Gastspeicher. IOMMU-Technik wie Intel VT-d oder AMD-Vi übersetzt und isoliert Gerätezugriffe, was für sichere Gerätezuweisung wichtig ist. Hardwareunterstützung allein ersetzt weder Hypervisor noch Betriebssystemkonfiguration.
| Beschleunigung | Beispiel | Voraussetzung |
|---|---|---|
| SIMD / Vektor | Bildverarbeitung, Kompression, wissenschaftliche Berechnung | Passender Code oder optimierte Bibliothek und unterstützte ISA-Erweiterung. |
| Kryptografie | AES, Hashfunktionen, TLS, Laufwerksverschlüsselung | Software nutzt die Hardwarebefehle korrekt und sicher. |
| Medienblöcke | H.264/H.265/AV1-Decoding oder -Encoding | Unterstützter Codec, Profil, Treiber und Anwendung. |
| GPU / NPU | Grafik, Machine Learning, Matrixoperationen | Geeignetes Modell, Laufzeitumgebung, Treiber und Speicherbudget. |
| Virtualisierung | Virtuelle Maschinen und Gerätezuweisung | CPU-, Firmware-, Hypervisor- und gegebenenfalls IOMMU-Unterstützung. |
Fertigungsprozess, Chiplets und Energie
Herstellerbezeichnungen wie 7 nm, 5 nm oder 3 nm sind heute Prozessknoten-Namen und kein verlässliches direktes Maß einer einzelnen Leiterbahnbreite oder Transistorabmessung. Unterschiedliche Foundries können gleich benannte Knoten nicht unmittelbar vergleichen. Aussagekräftiger sind Messwerte des fertigen Produkts: Leistung in konkreten Anwendungen, Leistungsaufnahme, Temperatur, Fläche und Effizienz.
Ein Prozessor kann monolithisch auf einem Die gefertigt oder aus mehreren Chiplets aufgebaut sein. Chiplets erlauben, Rechenkerne, I/O-Die und Cache in geeigneten Fertigungsprozessen zu kombinieren. Interconnect, Packaging und Speicheranbindung werden dadurch selbst zu wichtigen Teilen der Architektur. Leckströme und dynamische Schaltverluste erzeugen Wärme; Power-Gating, Clock-Gating, Spannungsregelung und Schlafzustände reduzieren den Verbrauch.
Stepping, Errata, Microcode und Sicherheit
Prozessoren können Hardwarefehler besitzen. Hersteller dokumentieren bekannte Abweichungen als Errata. Ein neues Stepping bezeichnet eine überarbeitete physische Revision. Manche Fehler lassen sich durch Firmware, Betriebssystem, Compiler oder Microcode umgehen; andere erfordern eine neue Siliziumrevision oder den Austausch betroffener Produkte.
Microcode-Updates verändern interne Abläufe bestimmter bereits vorgesehener Befehle und können Fehler sowie Sicherheitsprobleme entschärfen. Sie können eine CPU jedoch nicht beliebig um neue Hardwareeinheiten oder vollständige Befehlssätze erweitern. Updates werden häufig über UEFI-Firmware und zusätzlich beim Betriebssystemstart geladen. Nach öffentlich bekannten Seitenkanalproblemen gehören CPU-Microcode, Firmware und Betriebssystemupdates zur regulären Systemsicherheit.
| Begriff | Bedeutung |
|---|---|
| Codename | Entwicklungs- oder Familienname; nicht immer eindeutig und kein Ersatz für die genaue Modellnummer. |
| Stepping / Revision | Physischer Versionsstand eines Prozessordesigns. |
| Erratum | Dokumentierte Abweichung vom vorgesehenen Verhalten. |
| Microcode | Interne Steuerung komplexer Abläufe; aktualisierbar innerhalb der vorgesehenen Hardwaremöglichkeiten. |
| Mitigation | Software- oder Firmwaregegenmaßnahme, die Sicherheit erhöhen, aber Leistung oder Funktionen beeinflussen kann. |
Sockel, Kühlung und Prozessorauswahl
Desktop-CPUs werden häufig in LGA- oder PGA-Sockeln montiert; viele Notebook-, Smartphone- und Embedded-Prozessoren sind fest verlötet. Derselbe Sockel garantiert keine vollständige Kompatibilität. Chipsatz, Firmwareversion, elektrische Leistungsgrenzen, RAM-Unterstützung und Herstellerfreigabe müssen passen. Eine neue Prozessorgeneration benötigt nicht zwangsläufig einen neuen Sockel, und derselbe Sockel kann mehrere technisch getrennte Plattformgenerationen umfassen.
Für die Auswahl zählt die vorgesehene Arbeitslast: hohe Einzelthreadleistung, viele Kerne, große Caches, integrierte Grafik, Medienblöcke, NPU, ECC, Virtualisierung oder bestimmte PCIe-Ressourcen. Kühler, Gehäusebelüftung und Mainboard-Spannungsversorgung müssen Dauerlast bewältigen. TDP- oder Base-Power-Angaben sind herstellerspezifische Planungswerte und nicht automatisch die höchste reale Leistungsaufnahme.
- Exakte CPU-Supportliste und erforderliche UEFI-Version des Mainboards prüfen.
- Kern-, Thread- und Cache-Ausstattung anhand realer Arbeitslast bewerten.
- Integrierte Grafik ist nicht bei jeder Desktop-CPU vorhanden oder aktiv; Modellangaben prüfen.
- Speichertyp, Kanäle, ECC-Fähigkeit und maximale Kapazität mit CPU und Mainboard abgleichen.
- Kühlerfreigabe, Montagekit, Package-Leistungsgrenzen und Gehäusehöhe kontrollieren.
- Anwendungsnahe Benchmarks aus mehreren unabhängigen Tests verwenden und Energiebedarf mitbewerten.
Maschinensprache, Assembler und Compiler
Ein Prozessor führt codierte Maschinenbefehle aus. Assembler verwendet menschenlesbare Mnemonics, die ein Assemblerprogramm in Maschinencode übersetzt. Höhere Programmiersprachen werden je nach Laufzeitmodell kompiliert, interpretiert oder Just-in-Time übersetzt. Ein Compiler kann Optimierungen, Vektorisierung und Zielvarianten für unterschiedliche Prozessorfunktionen erzeugen.
Grundlegende Befehlsgruppen sind arithmetische und logische Operationen, Datenübertragung, Vergleiche, Sprünge, Unterprogrammaufrufe, atomare Operationen und Systembefehle. Moderne ISAs ergänzen Vektor-, Kryptografie-, Virtualisierungs- und spezielle Matrixfunktionen. Die interne Decodierung kann einen sichtbaren Maschinenbefehl in mehrere Mikrooperationen zerlegen.
Quellen zur fachlichen Prüfung
- Intel: Prozessortechniken - Turbo Boost, Hyper-Threading, Virtualisierung und Speichercontroller
- Intel: Performance Hybrid Architecture mit Performance- und Efficient-Cores
- AMD: Zen-Core- und Chiplet-Architektur
- AMD: EPYC-Architektur mit Core Complex Dies und I/O Die
- AMD: Chiplet Ecosystem - Speicher, Kohärenz und Power Management
- SPEC: herstellerunabhängige Benchmark-Suiten
PDF-Download nach Anmeldung
Zum Schutz der Unterrichtsunterlagen steht der PDF-Download ausschließlich angemeldeten Nutzern zur Verfügung.